O ChatGPT consegue ler o seu site?
Deixe o ChatGPT ler o seu site
O ChatGPT, o Gemini, o Claude e o Perplexity só podem recomendar o que os seus crawlers têm permissão para ler. Em cerca de 30 minutos, pode verificar o único ficheiro que decide isto e corrigi-lo se os bloquear.
· Pela equipa da Letzscale · 9 min de leitura ·
Nesta página
- Duração
- 30 minutos
- Dificuldade
- Fácil
- Quem
- Quem puder editar o seu site
- Precisa de
- Um browser e acesso às definições do seu site
- Verificado
- 13 de outubro de 2026
Parte dos guias Letzscale: correções gratuitas, passo a passo, que ajudam o ChatGPT e outros assistentes de IA a encontrar, compreender e recomendar a sua empresa. Ainda não sabe onde está? Comece pelo Guia 01: Verifique o que o ChatGPT diz sobre a sua empresa.
Porque é importante
Todos os sites podem ter um pequeno ficheiro de texto chamado robots.txt. Diz aos visitantes automáticos, chamados crawlers, que páginas podem ler. Se afastar o crawler que está por trás do ChatGPT, o ChatGPT não consegue ler as suas páginas. Passa então a depender do que outros sites dizem sobre si, ou não diz nada.
Os sites bloqueiam muitas vezes os crawlers de IA sem que ninguém o tenha decidido: uma regra copiada de um modelo, uma definição que ficou ativa depois de uma remodelação, ou um serviço de segurança que bloqueia robôs por defeito. Este guia descobre qual é o seu caso.
Antes · crawler bloqueado
Aberto ao domingo até às 18:00.
Depois · crawler permitido
Não. O Café Ribeiro está fechado ao domingo. Abre de segunda a sábado. Correto
Ilustração com uma empresa fictícia.
T2Já recebeu a sua Auditoria Starter? Este guia corrige o T2, "Acesso dos crawlers de IA", na página 07 (Preparação técnica e para agentes). Se o seu relatório gratuito o lista entre as suas principais correções, este guia mostra-lhe como o fazer por si.
Referência
Que crawlers deixar entrar
Cada assistente de IA usa os seus próprios crawlers. Alguns vão buscar páginas para responder às perguntas das pessoas. Outros recolhem texto para treinar futuros modelos de IA. Para ser nomeado nas respostas, o primeiro tipo tem de ser permitido. Permitir os crawlers de treino é uma escolha sua.
| Assistente | Nomes dos crawlers no robots.txt | O que faz |
|---|---|---|
| ChatGPT | OAI-SearchBotChatGPT-UserGPTBottreino | Respostas de pesquisa no ChatGPT. Visitas a páginas quando um utilizador pergunta; a OpenAI diz que o robots.txt pode não se aplicar a estas. Dados de treino. |
| Aplicação Gemini | GooglebotGoogle-Extended | O Google-Extended não é um crawler, mas um interruptor. Controla se a Google pode usar o seu conteúdo para treinar os modelos Gemini e para fundamentar respostas nas aplicações Gemini. Não afeta a Pesquisa Google. |
| AI Overviews e Modo IA da Google Os resumos de IA acima dos resultados da Google | Googlebot | O crawler normal da Google. A Google diz que não há requisitos adicionais: se pode aparecer na Google com um excerto, pode aparecer nos AI Overviews. |
| Bing (usado pela pesquisa do ChatGPT) | Bingbot | A pesquisa na web do ChatGPT recorre em parte ao Bing, por isso o crawler do Bing tem de ser permitido. |
| Claude | Claude-SearchBotClaude-UserClaudeBottreino | Índice de pesquisa. Visitas a páginas quando um utilizador pergunta. Dados de treino. |
| Perplexity | PerplexityBotPerplexity-User | Resultados de pesquisa com ligações. Visitas a páginas quando um utilizador pergunta; o Perplexity diz que, em geral, ignora o robots.txt nestas. |
| Siri e Apple | ApplebotApplebot-Extendedtreino | O Applebot alimenta a pesquisa na Siri, no Spotlight e no Safari. O Applebot-Extended é um interruptor, não um crawler: decide se a Apple pode usar o que o Applebot leu para treinar os seus modelos de IA. |
A nossa recomendação para a maioria das empresas
Permita tudo. Quer que o ChatGPT conheça os seus serviços, preços, horários e contactos, e um crawler bloqueado só ajuda os concorrentes cujos sites podem ser lidos. Se se opõe ao treino de IA, bloqueie apenas o GPTBot, o ClaudeBot e o Applebot-Extended: a OpenAI, a Anthropic e a Apple mantêm-nos separados dos seus crawlers de pesquisa. Não bloqueie o Google-Extended, a não ser que aceite ser menos usado nas respostas do Gemini.
Antes de começar
Tenha isto à mão
- O endereço exato do seu site, incluindo se começa por
www. - Um acesso ao editor do seu site (WordPress, Webflow, Wix) ou, num site feito à medida, o contacto do seu programador.
- Se o seu site passa pela Cloudflare, um acesso à sua conta Cloudflare. Não tem a certeza? O seu programador ou fornecedor de informática saberá.
Passos
Verifique e corrija o seu robots.txt
Abra o seu ficheiro robots.txt
Em qualquer browser, escreva o seu endereço seguido de
/robots.txt, por exemploasuaempresa.pt/robots.txt. Vai ver uma de três coisas:- Algumas linhas de texto. Bom, passe ao passo 2.
- Um erro de "página não encontrada". Não tem ficheiro, o que significa que todos os crawlers são permitidos. Pode parar aqui, ou criar um no passo 4 para acrescentar o seu sitemap.
- Qualquer outro erro, ou uma página de início de sessão. Envie o endereço ao seu programador: os crawlers podem não conseguir ler o ficheiro de todo.
letzscale.com/robots.txt · o nosso próprio ficheiro, outubro de 2026User-Agent: GPTBot User-Agent: OAI-SearchBot User-Agent: ChatGPT-User User-Agent: ClaudeBot User-Agent: Claude-User User-Agent: Claude-SearchBot User-Agent: PerplexityBot User-Agent: Perplexity-User User-Agent: Googlebot User-Agent: Google-Extended User-Agent: Bingbot User-Agent: Applebot User-Agent: Applebot-Extended Allow: / User-Agent: * Allow: / Host: https://letzscale.com Sitemap: https://letzscale.com/sitemap.xml
O nosso ficheiro nomeia cada crawler de IA e permite-lhe ler todas as páginas, e depois permite também todos os outros crawlers. A última linha aponta os crawlers para o nosso sitemap, a lista das nossas páginas. A linha
Hosté uma instrução antiga que a Google ignora, por isso não precisa dela.Procure linhas que bloqueiam a IA
O ficheiro é feito de grupos. Cada grupo começa com
User-agent:e o crawler a que se aplica. Um*significa "todos os crawlers não nomeados noutro sítio". Por baixo,Disallow: /significa "nada neste site" eAllow: /significa "tudo".Um crawler obedece apenas ao grupo que o nomeia de forma mais específica. Por isso, se um grupo nomear o
OAI-SearchBote disserDisallow: /, umAllow: /geral para todos os outros não ajuda. Procure este padrão:Exemplo de um ficheiro que bloqueia a IA (linhas a vermelho)# Todos podem ler o site... User-agent: * Allow: / # ...exceto estes, que ficam completamente de fora User-agent: GPTBot User-agent: OAI-SearchBot User-agent: ClaudeBot User-agent: PerplexityBot Disallow: /
Neste exemplo, a pesquisa do ChatGPT e o Perplexity não conseguem ler o site, por isso é improvável que o citem. Verifique também se há
Disallow: /diretamente por baixo deUser-agent: *. Isso bloqueia todos, incluindo a Google e o Bing, e é uma sobra frequente de um site que foi construído num servidor de teste.Verifique as definições que alteram o ficheiro por si
Na maioria das plataformas, não edita o ficheiro diretamente; uma definição escreve-o. Verifique a que se aplica ao seu caso:
WordPress
Definições → Leitura → Visibilidade para motores de pesquisa tem de estar desmarcada. Se usar um plugin de SEO (Yoast, Rank Math), a secção de ferramentas tem um editor de robots.txt.Webflow
Site settings → SEO → Indexing. Edite as regras, guarde e depois publique o site. Ajuda do WebflowWix
Dashboard → SEO & GEO → Tools and settings → Robots.txt Editor → View File. Ajuda do WixUsa a Cloudflare?
A Cloudflare é um serviço que muitos sites usam para velocidade e segurança. Pode bloquear os crawlers de IA à porta, mesmo quando o robots.txt os permite. No painel da Cloudflare, abra Security Settings e depois Configure AI bot policies. Mantenha a categoria Search em "Allow". Desde 15 de setembro de 2026, os novos domínios da Cloudflare bloqueiam por defeito os robôs de treino e de agentes nas páginas com anúncios. Documentação da Cloudflare. Para verificar cada crawler de IA um a um, e o seu alojamento ou plugins, veja o Guia 11.
Escreva ou atualize o ficheiro
Se editar o ficheiro por si, esta é a versão que recomendamos. Substitua o endereço do sitemap pelo seu. A maioria dos construtores de sites cria o sitemap por si em
/sitemap.xml. As linhas que começam por#são comentários. Retire o#das linhas de treino apenas se quiser recusar o treino de IA.robots.txt# Search engines and AI assistants may read every page User-agent: * Allow: / # Optional: opt out of AI model training only # User-agent: GPTBot # User-agent: ClaudeBot # User-agent: Applebot-Extended # Disallow: / Sitemap: https://www.asuaempresa.pt/sitemap.xml
- Guarde-o como texto simples com o nome exato
robots.txt, nunca a partir do Word, que pode acrescentar caracteres que o estragam. - Tem de ficar no topo do seu site:
asuaempresa.pt/robots.txt, não numa pasta. - Cada endereço precisa do seu próprio ficheiro:
loja.asuaempresa.pté separado deasuaempresa.pt.
- Guarde-o como texto simples com o nome exato
Confirme que funcionou
Confirme o que os crawlers veem agora
Abra asuaempresa.pt/robots.txt outra vez numa janela privada do browser, para ver a versão atual e não uma cópia guardada. Depois, confirme com os próprios motores de pesquisa:
- Google Search Console → Definições → robots.txt mostra a versão que a Google obteve por último e os problemas que encontrou. Ainda não tem o Search Console? O Guia 03 configura-o.
- Bing Webmaster Tools tem um testador de robots.txt que mostra se uma página é permitida ao Bingbot, de que a pesquisa na web do ChatGPT depende em parte.
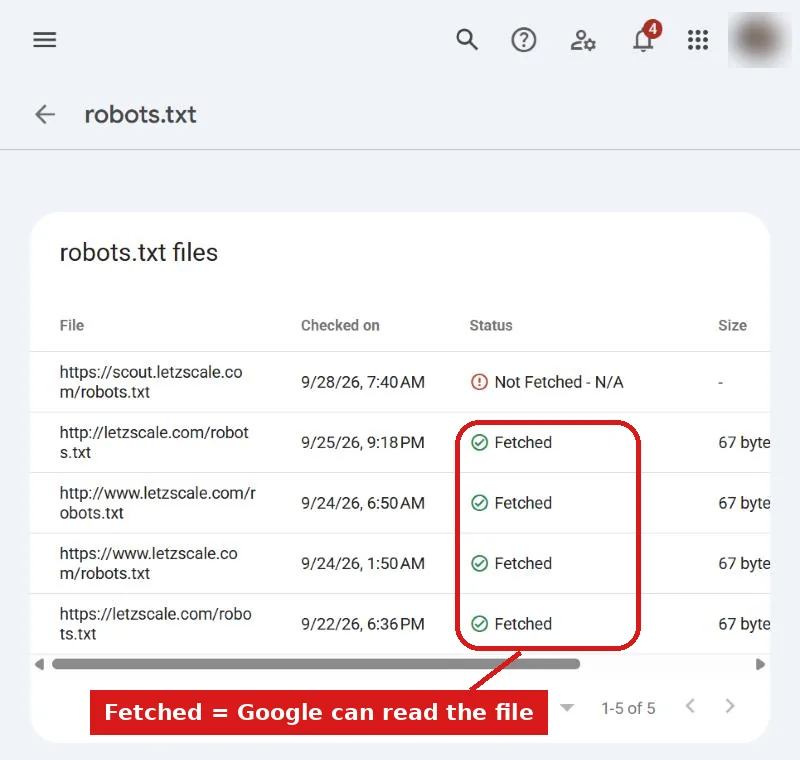
Dê-lhe um dia. A OpenAI diz que os seus sistemas de pesquisa podem demorar cerca de 24 horas a registar uma alteração; os outros crawlers seguem o seu próprio calendário.
Concluído quando
- O seu robots.txt abre num browser e mostra texto simples.
- Nenhum grupo diz
Disallow: /para*,Googlebot,Bingbot,OAI-SearchBot,Claude-SearchBot,PerplexityBotouApplebot. - A última linha aponta para o seu sitemap.
- Se usa a Cloudflare, a categoria Search está em "Allow".
Erros comuns
O que costuma correr mal
- Um bloqueio de site de teste que foi para o ar.
Disallow: /por baixo deUser-agent: *deixa todos de fora, a Google incluída. - Corrigir o endereço errado. O site funciona em
www.asuaempresa.ptmas o ficheiro foi alterado emasuaempresa.pt, ou o contrário. - Bloquear o Google-Extended para proteger a sua posição na Google. Não tem qualquer efeito na Pesquisa Google. Só controla como a Google usa o seu conteúdo para o Gemini.
- Tratar o robots.txt como uma fechadura. É um pedido público: os crawlers bem-comportados seguem-no, os outros não. Nunca o use para esconder páginas privadas.
- Esquecer a firewall. Um serviço de segurança pode bloquear um crawler que o robots.txt permite. Se o ficheiro parece certo e o ChatGPT continua sem conseguir ler o seu site, verifique a Cloudflare ou pergunte ao seu alojamento.
Fontes, verificadas a 13 de outubro de 2026
- OpenAI: Overview of OpenAI crawlers
- Anthropic: Does Anthropic crawl data from the web?
- Perplexity: Perplexity crawlers
- Apple: About Applebot
- Google: AI features and your website
- Google: Common crawlers (Google-Extended)
- Google: How to write and submit a robots.txt file
- Cloudflare: Block AI bots
- Webflow: Set robots.txt rules · Wix: Editing your site's robots.txt file